El robots.txt es un archivo de texto que le dice a los rastreadores por dónde pueden pasar y por dónde no. Es de los archivos más chicos de un sitio y de los que más daño hacen cuando quedan mal. El generador de NEUBOX lo arma con casillas y trae un probador para revisar una dirección antes de subir nada.
Herramienta: Generador de robots.txt
Paso 1. Empieza por una plantilla
Si tu sitio corre en WordPress o en Shopify, empieza por su plantilla. Traen bloqueadas las carpetas de administración y las rutas internas que no aportan nada en un buscador, y te ahorran acordarte de cuáles son.
Paso 2. Decide qué haces con los bots de inteligencia artificial
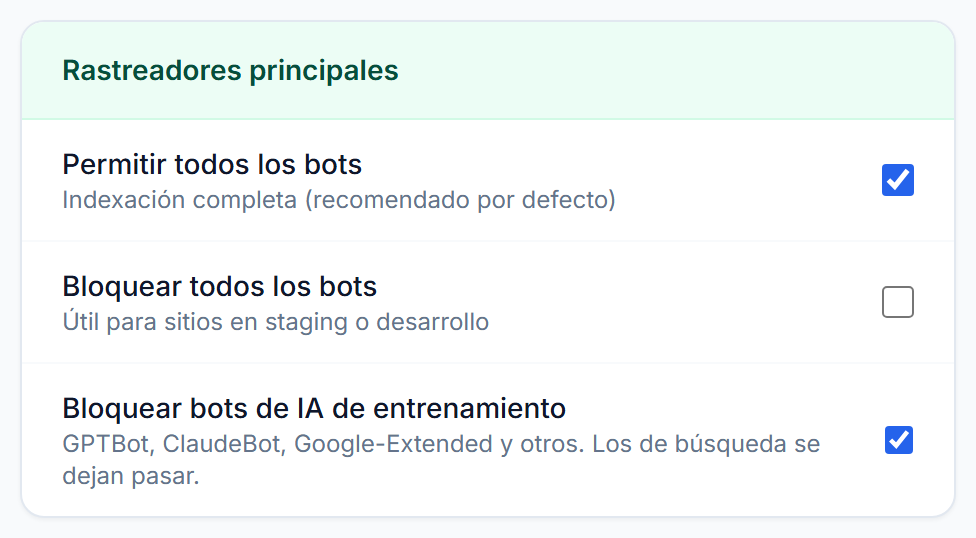
Esta casilla merece que la entiendas antes de marcarla, porque hay una distinción que casi nadie hace y que cambia el resultado por completo.
No todos los bots de IA hacen lo mismo. Hay dos familias:
- Los de entrenamiento recogen texto para entrenar modelos. Tu contenido se usa, y tú no recibes nada a cambio: ni visitas, ni mención.
- Los de búsqueda son los que consultan tu página en el momento en que alguien pregunta algo, para poder citarte en la respuesta. Ese sí te trae visitas.
La herramienta bloquea solo los de entrenamiento y deja pasar los de búsqueda. Es la decisión que tiene sentido para un negocio: bloquear los de búsqueda te saca de las respuestas donde te podrían recomendar.
Un detalle nada menor: los nombres de estos bots cambian. Muchos generadores en línea siguen emitiendo nombres que ya se retiraron, así que quien marca “bloquear IA” en esas herramientas no está bloqueando nada. El archivo se ve correcto y no hace nada.
Paso 3. Agrega tu sitemap y revisa el resultado
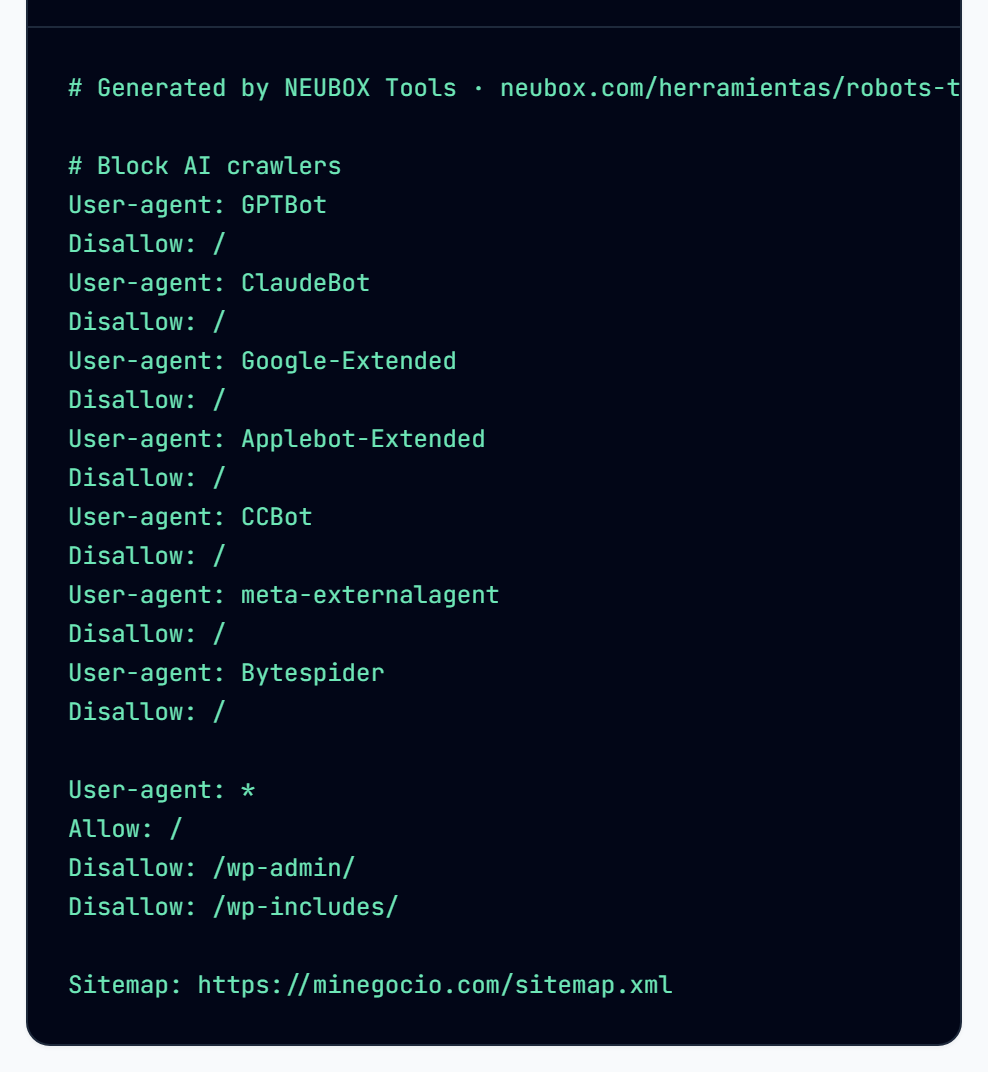
El renglón del sitemap no es opcional en la práctica: es como los buscadores que no son Google encuentran tu lista de páginas.
Paso 4. Prueba antes de subirlo
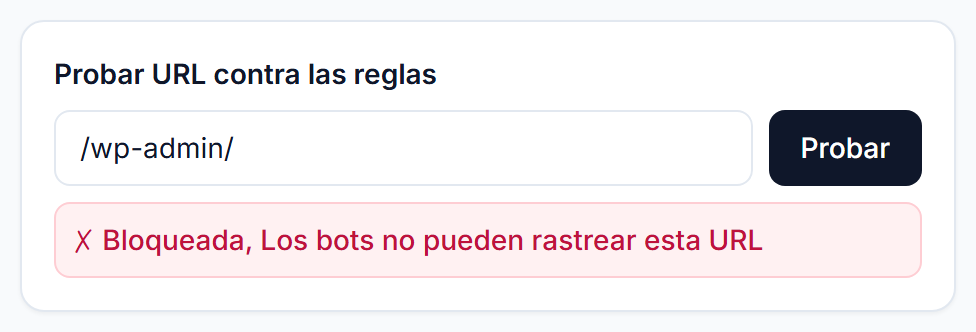
Prueba al menos tres direcciones antes de subir: tu página de inicio, una entrada del blog y una página de producto o servicio. Las tres deben salir permitidas. Si alguna sale bloqueada, tienes una regla de más.
El error clásico: bloquear y esperar que no se indexe
Este merece su propio apartado porque es la confusión más cara del SEO técnico.
Mucha gente quiere sacar una página de Google y hace dos cosas a la vez: la bloquea en robots.txt y le pone la etiqueta de no indexar. Suena a cinturón y tirantes. En realidad es un error, y las dos medidas se estorban.
El motivo: la etiqueta de no indexar vive dentro de la página. Si bloqueaste el rastreo, Google nunca entra a leerla, así que nunca se entera. Y como alguien enlaza esa dirección desde otro lado, Google la conoce igual y puede mostrarla en los resultados, solo que sin descripción, con el aviso de que no pudo ver el contenido.
- Para que una página no aparezca en Google: etiqueta de no indexar, y dejar que Google entre a leerla.
- Para que no gasten rastreo en una sección sin valor, como filtros o búsquedas internas: robots.txt.
Y algo que conviene tener claro siempre: el robots.txt es público. Cualquiera puede leer el tuyo escribiendo tudominio.com/robots.txt. Nunca lo uses para esconder una carpeta privada: lo único que consigues es publicar su nombre. Lo privado se protege con contraseña.
Paso 5. Súbelo a la raíz
El archivo tiene que quedar en tudominio.com/robots.txt, exactamente ahí. En una subcarpeta no sirve de nada: los rastreadores solo lo buscan en la raíz del dominio.
Compruébalo abriéndolo en el navegador. Si ves el texto, está bien puesto.
Herramientas que se usan junto con esta
- Generador de sitemap XML, que es lo que anuncia el último renglón del archivo.
- Generador de llms.txt, si además quieres explicarle a los buscadores con IA de qué trata tu sitio.
En la página de la herramienta está la guía completa, con los casos de uso más comunes.